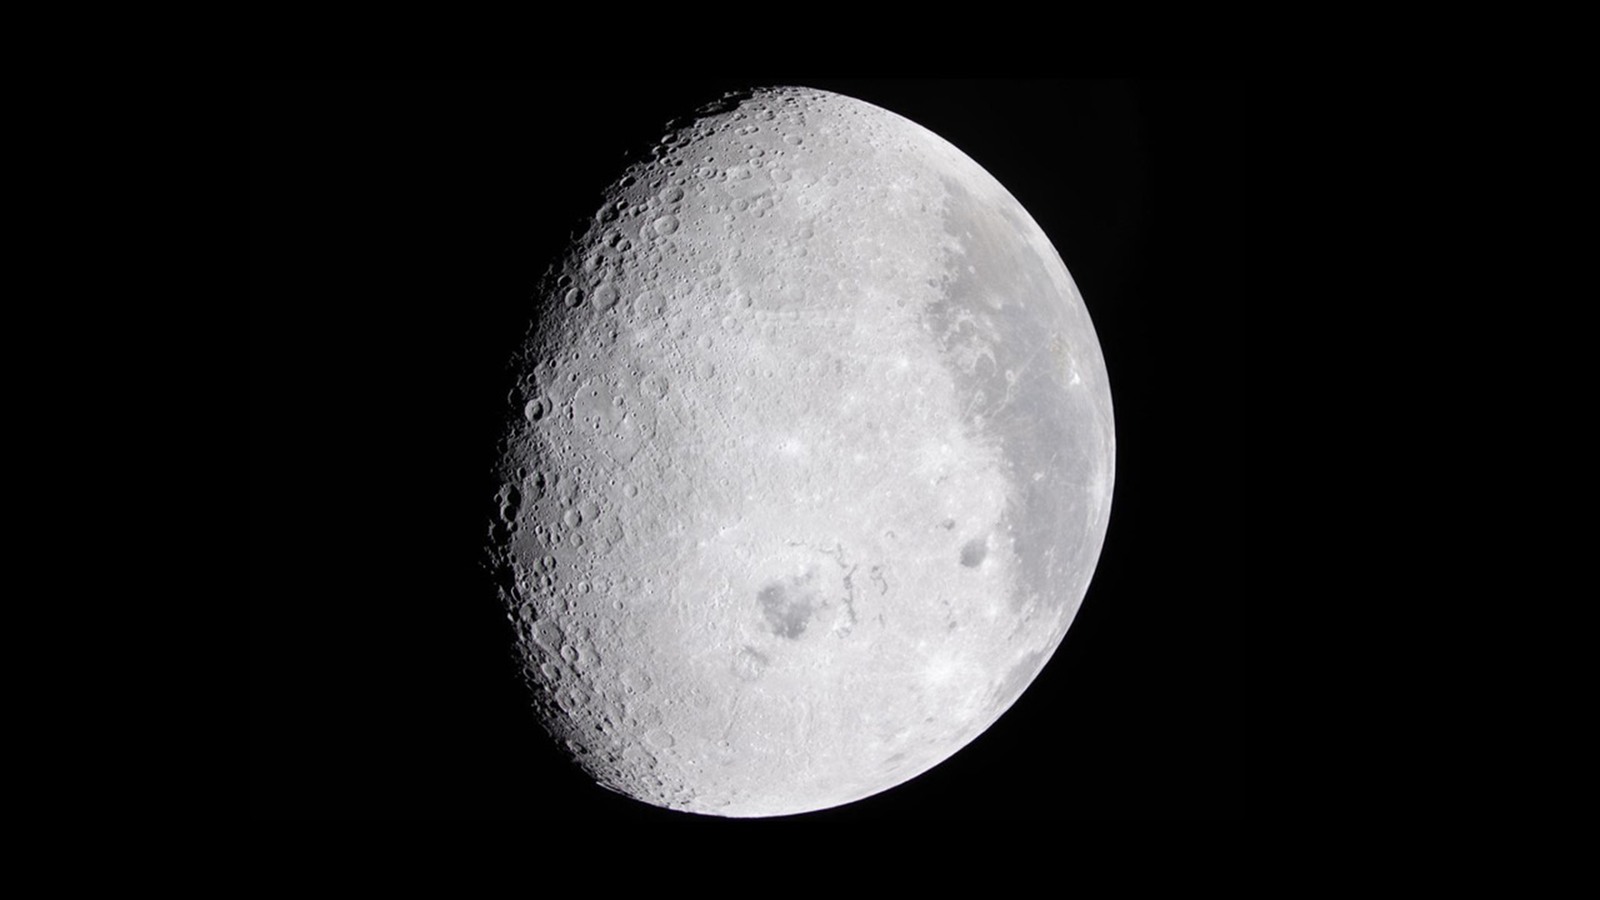
9月10日,IBM与NASA发布开源NASA-IBM Lunar Foundation Model,并同步开放面向机器学习整理的月球数据集。数据集包含来自4项任务、9台仪器的30多个空间对齐图层,主要来源包括NASA月球勘测轨道器、GRAIL任务及日本SELENE/Kaguya任务。模型面向潜在月冰、月海不规则斑块与陨石坑等科学任务。它是一套研究基础设施,不是自动选址或任务决策系统;性能数字来自特定数据、标签和对照模型,也不能直接外推到所有月球遥感问题。
信息边界:本条以IBM与NASA当日发布的信息为事实基线。未披露的合同分期、收入确认、利润贡献、客户订单、交割比例、监管许可与进度保证均不作推断;计划、目标、可选项和已经完成的事实分别处理。后续只有在原始主体、监管机构或交易所形成新增证据时,才更新对项目成熟度和商业结果的判断,远期规模不作为当前产能或业绩。
真正稀缺的资产,是跨仪器数据被放进同一坐标
月球观测长期分散在不同任务、分辨率、传感器和数据格式中。研究人员往往需要先做几何配准、分辨率转换和质量控制,才能训练单一任务模型。IBM与NASA把多模态、多分辨率数据整理成统一数据集,使研究者能从共享表征出发再微调,而不是每个问题从头搭建管线。30多个图层与9台仪器的价值在于数据工程和可复用性;开源则允许外部团队复现、发现偏差并扩展到新的地质问题。
“最高23%”必须还原到具体任务
IBM新闻稿用“最高23%”概括相对常用方法的改善,技术细节显示:潜在月冰识别相对SwinV2-B的均方根误差最多降低22%;月海不规则斑块的范围识别提高约3%;在约100米上下文尺度的陨石坑任务中,模型使用一半训练数据仍取得接近19%的提升。不同指标不能相加,也不能视为模型对所有地貌统一提高23%。此外,潜在冰区仍需光谱、雷达、热环境与现场测量等证据交叉确认,模型输出只是候选区域和研究优先级。
下一步要看科研复用,而非发布当天的榜单
开源模型加入IBM的Prithvi系列,降低大学和小型团队进入月球多模态分析的门槛。后续价值应由外部复现、迁移到新区域的稳健性、不确定性校准和真实任务采用来判断。数据覆盖不均、标签噪声与极区光照条件可能造成系统偏差;科学团队还需保留原始观测和物理模型的约束。若模型帮助研究者更快筛选着陆区或资源勘测目标,它会提高任务准备效率;但最终安全和资源判断仍要由多源证据、专家审查及后续探测完成。